
AI и ML
Jev от TypeSafe AI: как System One меняет автоматизацию
Jev — первая публичная «System One» модель от TypeSafe AI: вместо текста она возвращает типизированные, калиброванные решения за 70–500 мс. Разбираем архитектуру, примитивы Choice, Score и Noul и реальные сценарии.
- Опубликовано
- 21 сентября 2026 г.
- Обновлено
- 21 сентября 2026 г.
- Автор
- Виталий Шинкаренко
- ⏱
- 5 мин
Коротко: Jev — это не чат-бот, а «функция вызова» с фронтирным интеллектом. Она принимает неструктурированное состояние и возвращает типизированные вероятностные решения, которые софт может использовать без парсинга и валидации.
Главное
- Jev возвращает типизированные вероятностные решения вместо текста — соответствие схеме гарантировано
- Параллельный сэмплер и обучение RLCD дают 70–500 мс и калиброванную уверенность
- Три примитива — Choice, Score, Noul — можно задавать вместе в одном запросе
- $42 за миллиард входных токенов, выходные токены бесплатны
Введение: за пределами парадигмы чат-бота
Переход от «разговоров» к «действиям» давно остаётся главным узким местом в автоматизации на основе ИИ. Большие языковые модели (LLM) достигли сверхчеловеческого уровня в диалоге, но их архитектура, оптимизированная под понятную людям прозу, плохо подходит для строгих структурированных требований продакшн-софта.
Диогу Алмейда, сооснователь TypeSafe AI, чьи исследования в OpenAI заложили основу для ChatGPT, увидел этот пробел: последовательные модели генерации текста не обладают скоростью и надёжностью, необходимыми для автономного принятия решений. Ответ TypeSafe — Jev, первая публичная «System One Model». Она описана в манифесте TypeSafe (откроется в новой вкладке) и в официальном блоге запуска (откроется в новой вкладке).
Архитектура решения: System One против System Two
Название отсылает к книге Даниэля Канемана «Думай медленно… решай быстро», где человеческое мышление делится на System 1 (быстрое, интуитивное, автоматическое) и System 2 (медленное, обдуманное, логическое). Jev — радикальный отход от «System 2»-подобных рассуждений LLM, и держится он на двух инновациях.
Параллельное сэмплирование. Традиционные LLM генерируют по одному токену в авторегрессивном цикле — это медленно и ресурсоёмко. Jev использует Parallel Sampler, который генерирует все выходы одним запросом. Это позволяет одновременно задавать несколько независимых вопросов об одном состоянии без задержек, типичных для последовательной генерации.
RLCD (Reinforcement Learning for Calibrated Decisions). Большинство LLM настраивают через RLHF, чтобы они выдавали приятный людям текст. Jev обучен через RLCD, который приоритизирует «эпистемически честные» вероятности. Это калибровка: уверенность модели (например, 0,8) — прямой показатель статистической вероятности правильного ответа.
Технические характеристики и бенчмарки
Jev оптимизирован под профиль интеллекта «коммунального масштаба», который текущие фронтирные модели не могут воспроизвести в задачах принятия решений большого объёма. Сравнение с существующими LLM:
| Параметр | Существующие LLM | System One (Jev) |
|---|---|---|
| Оптимизация | RLHF / RLVR (человеческие предпочтения) | RLCD (калиброванные решения) |
| Выход | строки и авторегрессивный текст | типобезопасные структурированные значения |
| Сэмплирование | последовательное (токен за токеном) | параллельное (один запрос) |
| Надёжность | риск галлюцинаций, нужен парсинг | гарантированное соответствие схеме, ноль ошибок типов |
По данным Workflow Evals (откроется в новой вкладке), в сложных автоматизированных воркфлоу Jev в 193,6 раза быстрее и в 444,6 раза экономичнее фронтирных моделей вроде GPT-6 Astra или Fable 5.1. Сами авторы называют эти цифры верхней границей реальных результатов; для сопоставимого интеллекта они приводят типичное ускорение в 40–200 раз.
- 64k
- входных токенов
- контекстное окно
- 70–500 мс
- задержка
- до 200× быстрее традиционных фронтирных моделей
- $0,042
- за 1 млн токенов входа
- $42 за миллиард токенов
- $0
- выходные токены
- «too cheap to meter»
Функциональные примитивы: Choice, Score и Noul
Jev взаимодействует с софтом через три типа «вопросов». Параллельный сэмплер физически ограничен заранее заданной схемой, поэтому модель математически не может выдать ошибку типа или придумать значение, не подходящее под структуру. Перед вопросами разработчик описывает State — это может быть сырой текст, структурированные данные или сообщения LangChain.
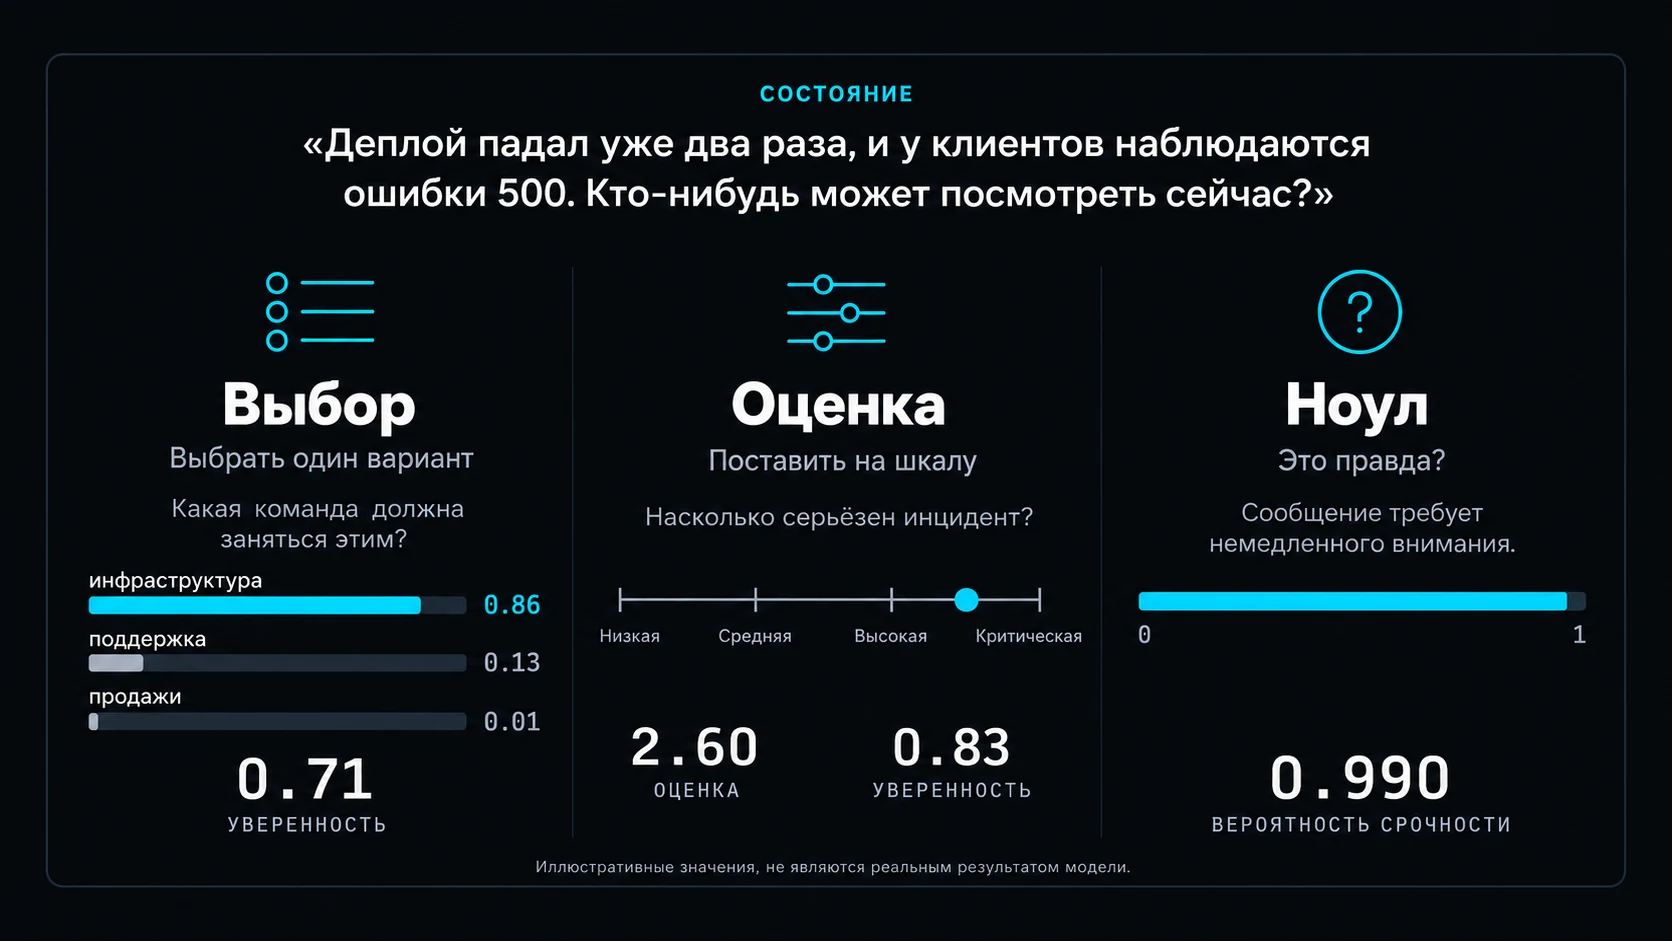
Choice
Выбор из заранее заданного набора вариантов. Возвращает вероятность для каждого варианта и общую уверенность. Jev поддерживает до 255 вариантов. Для задач с большей кардинальностью используется двухэтапная система: сначала независимая оценка, затем явный выбор — так сохраняется точность. Пример: сортировка писем по категориям Work, Marketing, Finance, Security.
Score
Оценка входных данных по упорядоченным уровням (например, Low, Medium, High, Critical). В отличие от дискретной классификации, возвращает непрерывные распределения и значения по шкале, заданной разработчиком, — это даёт тонкое ранжирование по важности или срочности. Пример: срочность обращения в поддержку или качество лида.
Noul
Вероятностный ответ «да/нет» на конкретное утверждение (например, «Это фишинг?»). Возвращает прямую вероятность от 0,0 до 1,0 (например, 0,999), что утверждение истинно. Пример: является ли письмо мошенническим, опасна ли предложенная системная команда.
Для кого Jev — и для кого нет
Используйте Jev для
- «Умные if-условия»: классификация, маршрутизация тикетов, скоринг лидов и ветвление бизнес-логики в коде
- Приложения реального времени, где UX зависит от минимальной задержки (70–500 мс)
- Защитные барьеры (guardrails): мгновенная оценка безопасности промпта или вызова инструмента до того, как агент начнёт действовать
- Автономные агенты и боты: браузерные агенты, игровые боты, алгоритмические торговые сигналы
Оставайтесь на обычной LLM для
- Свободный текст: чат-боты, копирайтинг, написание кода
- Работа с человеком в контуре: копилоты и диалоговые ассистенты
- Рассуждения «вслух» шаг за шагом (chain-of-thought)
Чем Jev отличается от классификаторов и обычных LLM
По сравнению с классическим ML (BERT, scikit-learn). Классическим классификаторам нужен размеченный датасет и обучение под каждую задачу. Jev читает контекст на естественном языке до 64k токенов с фронтирным пониманием, поэтому вы описываете вопрос, а не обучаете модель.
По сравнению со structured output у GPT или Claude. Обычная LLM пишет ответ токен за токеном — вместе с JSON, — поэтому тратит медленные платные выходные токены и всё равно может сломать формат или выдумать параметр. Jev вообще не генерирует строк: параллельный сэмплер сразу вычисляет вероятности для всех заранее заданных вопросов, и ответ всегда соответствует схеме.
Что такое калибровка на практике. Если Jev выдаёт уверенность 0,8, он должен быть прав примерно в 80 случаях из 100 похожих, тогда как обычные LLM часто переоценивают себя. Чтобы проверить это на своих данных, прогоните Jev по размеченной выборке и сравните его уверенность с реальной точностью.
Альтернативы, которые стоит рассмотреть
- Классические ML-модели
BERT, RoBERTa, FastText, scikit-learn — дёшевы в работе, но требуют сбора данных и обучения под каждую задачу.
- Structured outputs и function calling
Обычная LLM от OpenAI или Anthropic, ограниченная JSON-схемой. Гибко, но медленнее и оплата за выходные токены.
- Малые LLM с промптом
Лёгкие модели вроде Llama 3 8B, которым в промпте задана классификация: дешевле фронтирных, но всё равно генерируют текст токен за токеном.
Чего Jev не умеет
Jev меняет генерацию текста на скорость и надёжность. Отсюда очевидные последствия:
- Не генерирует текст. Он не напишет даже одного предложения или ответа в чате.
- Нет chain-of-thought. Пошаговых рассуждений, которые можно прочитать, не будет.
- Не выполняет инструменты. Он может оценить, безопасен ли вызов инструмента, но сам вызов не делает.
Реальные применения и прототипирование
Быстрый и дешёвый интеллект Jev открывает сценарии, которые раньше были экономически или технически недостижимы.
Корпоративные воркфлоу. Jev отлично справляется с массовым триажем: в демонстрациях он обрабатывает от 500 до 1700 писем за секунды за копейки. Агентства используют его для мгновенного скоринга лидов и маршрутизации входящих запросов по качеству.
Агентная инфраструктура. Jev работает как «регулировщик» маршрутизации моделей, выбирая самую дешёвую модель (например, «Nano» для простых запросов). В «Auto Mode» он выступает предохранителем — выявляет рискованные bash-команды или вызовы инструментов до того, как автономный агент их выполнит.
- Бот для Doom
реактивный агент принимает 10 решений в секунду по состоянию игры
- Wikiracing
навигация по Википедии с анализом сотен ссылок на шаге без галлюцинаций
- Автоматизация браузера
сквозные задачи, например бронирование рейса Цюрих — Лондон, за 7 секунд
- Финансовые сервисы
живые торговые сигналы для Bitcoin или акций — решения buy/hold/sell на основе потоков данных с оценкой уверенности
Интеграция для разработчиков и экосистема
Jev создан, чтобы вписываться в современный AI-стек как детерминированный компонент. Пакет langchain-typesafe предоставляет TypeSafeClassifier — его удобно использовать в агентных циклах для быстрых решений, оставляя медленные и дорогие LLM для финальной генерации текста. В примере классификатор получает состояние «Деплой упал дважды, клиенты видят 500-е ошибки, кто-нибудь может посмотреть сейчас?» и вопрос Noul «Требует ли это внимания прямо сейчас?», а калиброванная вероятность срочности читается напрямую из response.nouls["urgent"].noul.
Альтернативный доступ — через Vercel AI Gateway (откроется в новой вкладке) со стандартным API-ключом, что упрощает интеграцию в веб-приложения. Для более глубоких руководств есть официальная документация (откроется в новой вкладке) и API Console (откроется в новой вкладке).
from langchain_typesafe import Noul, TypeSafeClassifier

# Initialize the classifier
classifier = TypeSafeClassifier()

# Invoke with a state and specific questions
response = classifier.invoke(
    state="The deploy failed twice and customers are seeing 500s. Can someone look now?",
    questions={
        "urgent": Noul(instructions="Does this need attention right now?")
    },
)

# Access calibrated probability directly
urgency_score = response.nouls["urgent"].noulБыстрый старт
- Получите API-ключ
Создайте его в API Console (откроется в новой вкладке) или используйте Jev через Vercel AI Gateway (откроется в новой вкладке) со стандартным ключом. Сохраните его в переменной окружения TYPESAFE_API_KEY.
- Установите интеграцию
Для Python выполните pip install langchain-typesafe. В пакете есть TypeSafeClassifier, а также ModelRouterMiddleware и AutoModeMiddleware для маршрутизации моделей и защитных барьеров.
- Опишите состояние
Передайте сырой текст, структурированные данные или сообщения LangChain.
- Задайте вопросы
Для каждого вопроса выберите Choice, Score или Noul — всё в одном запросе.
- Прочитайте вероятности
Используйте типизированный результат прямо в коде, например response.nouls["urgent"].noul.
Заключение: парадокс Джевонса и будущее интеллекта
Модель названа в честь Уильяма Стэнли Джевонса, экономиста, заметившего: чем эффективнее используется ресурс (например, уголь), тем больше его потребляют. TypeSafe AI считает, что удешевление «System One»-интеллекта на несколько порядков приведёт к массовому проникновению ИИ в каждый слой софта.
Предоставив типобезопасный интерфейс, на который можно положиться, Jev превращает ИИ из ненадёжного собеседника в надёжный, невидимый двигатель глобальной автоматизации. Интеллект больше не узкое место — это интерфейс.
Частые вопросы
Jev — это LLM?
Нет. Jev понимает естественный язык, как LLM, но не генерирует текст токен за токеном. Он возвращает только структурированные решения с калиброванными вероятностями.
Что значит System One?
Название происходит от книги Даниэля Канемана «Думай медленно… решай быстро»: System 1 — это быстрое интуитивное принятие решений в отличие от медленных обдуманных рассуждений System 2.
Сколько стоит Jev?
Входные токены стоят $0,042 за миллион ($42 за миллиард). Выходные токены бесплатны. Полные тарифы смотрите в [API Console](https://console.typesafe.ai/).
Может ли Jev галлюцинировать?
Он не может выдумать типы данных, структуру JSON или текст, потому что ответы ограничены вашей схемой. Как и любая модель, он может ошибиться в значении — именно для этого есть калиброванная уверенность.
Как подключить Jev через LangChain или Vercel?
В LangChain используйте пакет langchain-typesafe и класс TypeSafeClassifier. На Vercel модель доступна через [Vercel AI Gateway](https://vercel.com/ai-gateway) со стандартным API-ключом.
01 — Новости
Похожие новости
Своя CRM, HubSpot или Odoo: как выбрать и не ошибиться
Сколько на самом деле стоят HubSpot, Odoo или собственная CRM за 3 года, когда что выбирать и по каким признакам видно, что готовая CRM вам уже мала.
Что такое разработка сайтов и что входит в реальный проект
Что такое разработка сайта, из каких этапов состоит проект, что должно входить в цену и как выбрать между лендингом, корпоративным сайтом и интернет-магазином.
Кастомная разработка сайта или готовые решения: что выбрать для бизнеса
Кастомная разработка или готовые решения (шаблоны, конструкторы, no-code) — сравниваем гибкость, стоимость и сроки, чтобы помочь выбрать правильный подход для вашего бизнеса.
02 — Контакты
Расскажите, что вам нужно
Ответим с предложением.
Удобнее поговорить?
Записаться на звонок 15 минутНаписать в TelegramИли напишите на [email protected]