
IA y ML
Jev de TypeSafe AI: cómo System One redefine la automatización
Jev es el primer modelo público «System One» de TypeSafe AI: en lugar de texto, devuelve decisiones tipadas y calibradas en 70–500 ms. Analizamos la arquitectura, los primitivos Choice, Score y Noul y casos de uso reales.
- Publicado
- 21 de septiembre de 2026
- Actualizado
- 21 de septiembre de 2026
- Autor
- Vitalii Shynkarenko
- ⏱
- 6 min
Respuesta corta: Jev no es un chatbot, sino una «llamada a función» con inteligencia de frontera. Recibe un estado no estructurado y devuelve decisiones probabilísticas tipadas que el software puede usar sin parseo ni validación.
Ideas clave
- Jev devuelve decisiones probabilísticas tipadas en lugar de texto — el ajuste al esquema está garantizado
- El muestreador paralelo y el entrenamiento RLCD ofrecen 70–500 ms y confianza calibrada
- Tres primitivos — Choice, Score, Noul — se pueden preguntar juntos en una sola petición
- 42 $ por mil millones de tokens de entrada, los de salida son gratis
Introducción: más allá del paradigma del chatbot
El paso de «conversar» a «actuar» lleva tiempo siendo el principal cuello de botella de la automatización con IA. Los grandes modelos de lenguaje (LLM) han alcanzado un rendimiento conversacional sobrehumano, pero su arquitectura, optimizada para una prosa que gusta a las personas, encaja mal con los requisitos rigurosos y estructurados del software en producción.
Diogo Almeida, cofundador de TypeSafe AI, cuya investigación en OpenAI ayudó a sentar las bases de ChatGPT, detectó esta brecha: los modelos secuenciales de generación de texto carecen de la velocidad y la fiabilidad necesarias para la toma de decisiones autónoma. La respuesta de TypeSafe es Jev, el primer «System One Model» público. Se describe en el Manifiesto de TypeSafe (se abre en una pestaña nueva) y en el blog oficial de lanzamiento (se abre en una pestaña nueva).
La arquitectura de la decisión: System One frente a System Two
El nombre alude a «Pensar rápido, pensar despacio» de Daniel Kahneman, que divide la cognición humana en System 1 (rápido, intuitivo, automático) y System 2 (lento, deliberado, lógico). Jev rompe de forma radical con el razonamiento tipo System 2 de los LLM y se apoya en dos innovaciones.
Muestreo paralelo. Los LLM tradicionales generan un token cada vez en un bucle autorregresivo, lo que es lento y costoso. Jev usa un Parallel Sampler que genera todas las salidas en una sola consulta. Así puede responder varias preguntas independientes sobre un mismo estado a la vez, sin la latencia típica de la generación secuencial.
RLCD (Reinforcement Learning for Calibrated Decisions). La mayoría de los LLM se ajustan con RLHF para producir texto que a las personas les resulte agradable. Jev se entrena con RLCD, que prioriza probabilidades «epistémicamente honestas». Es calibración: la confianza del modelo (por ejemplo, 0,8) es un indicador directo de la probabilidad estadística de acierto.
Especificaciones técnicas y benchmarks
Jev está optimizado para un perfil de inteligencia a escala de servicio público que los modelos de frontera actuales no pueden replicar en tareas de decisión de alto volumen. Comparación con los LLM existentes:
| Parámetro | LLM existentes | System One (Jev) |
|---|---|---|
| Optimización | RLHF / RLVR (preferencia humana) | RLCD (decisiones calibradas) |
| Salida | cadenas y texto autorregresivo | valores estructurados con tipado seguro |
| Muestreo | secuencial (token a token) | paralelo (una sola consulta) |
| Fiabilidad | riesgo de alucinaciones, requieren parseo | ajuste garantizado al esquema, cero errores de tipo |
Según Workflow Evals (se abre en una pestaña nueva), en flujos de automatización complejos Jev es 193,6 veces más rápido y 444,6 veces más económico que modelos de frontera como GPT-6 Astra o Fable 5.1. Los propios autores describen estas cifras como el extremo alto de las ganancias reales; para una inteligencia comparable citan una aceleración típica de 40x–200x.
- 64k
- tokens de entrada
- ventana de contexto
- 70–500 ms
- latencia
- hasta 200 veces más rápido que los modelos de frontera tradicionales
- 0,042 $
- por MTok de entrada
- 42 $ por mil millones de tokens
- 0 $
- tokens de salida
- «too cheap to meter»
Los primitivos funcionales: Choice, Score y Noul
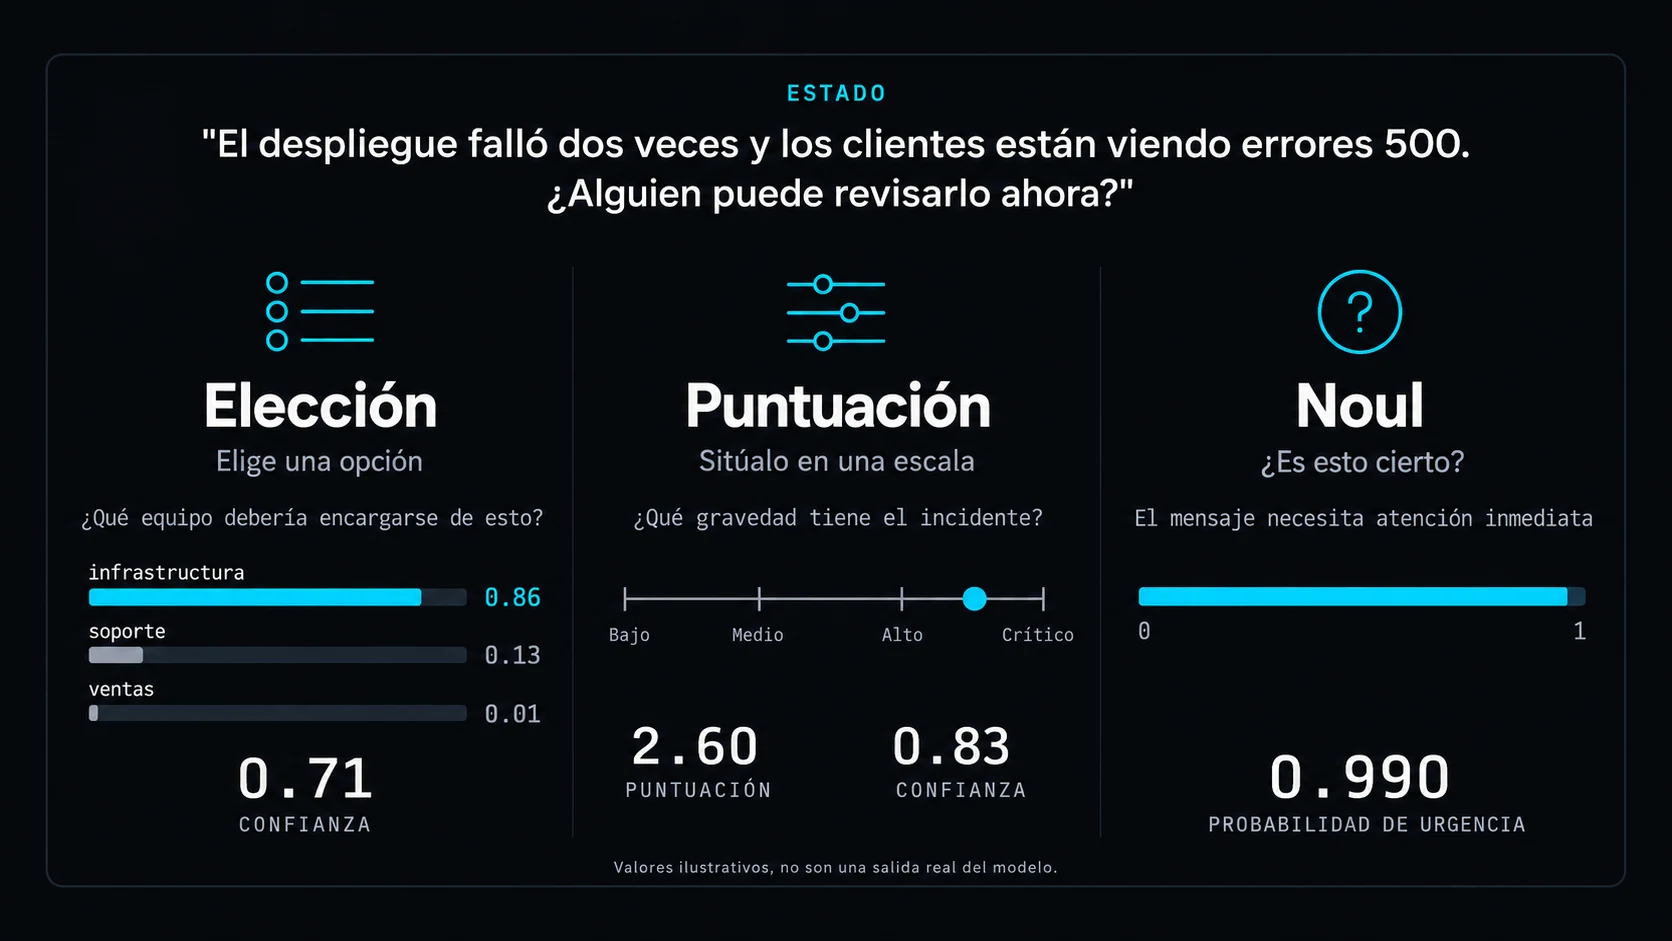
Jev interactúa con el software mediante tres tipos de «pregunta». El muestreador paralelo está limitado físicamente por un esquema predefinido, lo que hace matemáticamente imposible que el modelo produzca un error de tipo o un valor que no encaje en la estructura. Antes de preguntar, el desarrollador define el State, que puede incluir texto sin procesar, datos estructurados o mensajes de LangChain.
Choice
Elige entre un conjunto predefinido de opciones. Devuelve una probabilidad por opción y una puntuación de confianza global. Jev admite hasta 255 opciones. Para tareas de mayor cardinalidad usa un sistema en dos etapas: primero puntúa de forma independiente y luego hace una elección explícita, para mantener la precisión. Ejemplo: clasificar correos en Work, Marketing, Finance o Security.
Score
Valora la entrada según niveles ordenados (por ejemplo, Low, Medium, High, Critical). A diferencia de la clasificación discreta, devuelve distribuciones continuas y valores en una escala definida por el desarrollador, lo que permite un ranking fino por importancia o urgencia. Ejemplo: la urgencia de una solicitud de soporte o la calidad de un lead.
Noul
Una respuesta probabilística de sí/no a una afirmación concreta (por ejemplo, «¿Esto es phishing?»). Devuelve la probabilidad directa, de 0,0 a 1,0 (por ejemplo, 0,999), de que la afirmación sea cierta. Ejemplo: si un correo es una estafa o si un comando de sistema propuesto es peligroso.
Para quién es Jev — y para quién no
Usa Jev para
- «If» inteligentes: clasificación, enrutamiento de tickets, puntuación de leads y ramificación de la lógica de negocio en el código
- Aplicaciones en tiempo real donde la UX depende de una latencia mínima (70–500 ms)
- Barreras de seguridad (guardrails): valorar al instante si un prompt o una llamada a herramienta es seguro antes de que el agente actúe
- Agentes y bots autónomos: agentes de navegador, bots de juegos, señales de trading algorítmico
Quédate con un LLM normal para
- Texto libre: chatbots, copywriting, escribir código
- Trabajo con humano en el circuito: copilotos y asistentes conversacionales
- Razonamiento paso a paso en voz alta (chain-of-thought)
En qué se diferencia Jev de los clasificadores y de los LLM normales
Frente al ML clásico (BERT, scikit-learn). Los clasificadores clásicos necesitan un conjunto de datos etiquetado y entrenamiento para cada tarea. Jev lee contexto en lenguaje natural de hasta 64k tokens con comprensión de nivel frontera, así que describes la pregunta en lugar de entrenar un modelo.
Frente al structured output de GPT o Claude. Un LLM normal escribe su respuesta token a token — incluido el JSON —, por lo que gasta tokens de salida lentos y de pago y aun así puede romper el formato o inventarse un parámetro. Jev no genera cadenas en absoluto: un muestreador paralelo calcula a la vez las probabilidades de todas las preguntas predefinidas y la respuesta siempre encaja con el esquema.
Qué significa la calibración en la práctica. Si Jev indica una confianza de 0,8, debería acertar en unos 80 de cada 100 casos similares, mientras que los LLM normales suelen ser demasiado confiados. Para comprobarlo con tus datos, pasa Jev por una muestra etiquetada y compara su confianza con la precisión real.
Alternativas que conviene considerar
- Modelos de ML clásicos
BERT, RoBERTa, FastText, scikit-learn: baratos de ejecutar, pero requieren recopilar datos y entrenar para cada tarea.
- Structured outputs y function calling
Un LLM normal de OpenAI o Anthropic limitado a un esquema JSON. Flexible, pero más lento y con cobro por token de salida.
- LLM pequeños con prompt
Modelos ligeros como Llama 3 8B a los que se pide clasificar: más baratos que los de frontera, pero siguen generando texto token a token.
Lo que Jev no puede hacer
Jev cambia la generación de texto por velocidad y fiabilidad. Las consecuencias son claras:
- No genera texto. No puede escribir ni una sola frase ni una respuesta de chat.
- Sin chain-of-thought. No hay razonamiento paso a paso que se pueda leer.
- No ejecuta herramientas. Puede valorar si una llamada a una herramienta es segura, pero no hace la llamada.
Aplicaciones reales y prototipado
El perfil de inteligencia rápida y barata de Jev habilita casos de uso que antes eran inviables económica o técnicamente.
Flujos empresariales. Jev destaca en el triaje de alto volumen: en las demostraciones procesa entre 500 y 1.700 correos en segundos por céntimos. Las agencias también lo usan para puntuar leads al instante y enrutar las consultas entrantes según su calidad.
Infraestructura agéntica. Jev actúa como «agente de tráfico» del enrutamiento de modelos, eligiendo el modelo más barato (por ejemplo, uno «Nano» para consultas simples). En «Auto Mode» funciona como barrera de seguridad, detectando comandos bash o llamadas a herramientas de riesgo antes de que un agente autónomo los ejecute.
- El bot de «Doom»
un agente reactivo que toma 10 decisiones por segundo según el estado del juego
- Wikiracing
navegar por Wikipedia analizando cientos de enlaces por paso, sin alucinaciones
- Automatización del navegador
tareas complejas de extremo a extremo, como reservar un vuelo de Zúrich a Londres, en solo 7 segundos
- Servicios financieros
señales de trading en vivo para Bitcoin o acciones — decisiones buy/hold/sell a partir de flujos de datos, con puntuaciones de confianza
Integración para desarrolladores y ecosistema
Jev está pensado para encajar en el stack de IA moderno como un componente determinista. El paquete langchain-typesafe ofrece TypeSafeClassifier, ideal dentro de bucles de agentes para decisiones rápidas, reservando los LLM lentos y caros para la generación final de prosa. En el ejemplo, el clasificador recibe el estado «El despliegue falló dos veces y los clientes ven errores 500. ¿Alguien puede mirarlo ya?» y una pregunta Noul «¿Requiere atención ahora mismo?», y la probabilidad calibrada de urgencia se lee directamente de response.nouls["urgent"].noul.
También se puede acceder mediante el Vercel AI Gateway (se abre en una pestaña nueva) con una clave de API estándar, lo que simplifica la integración en aplicaciones web. Para guías de implementación más detalladas, consulta la documentación oficial (se abre en una pestaña nueva) y la API Console (se abre en una pestaña nueva).
from langchain_typesafe import Noul, TypeSafeClassifier

# Initialize the classifier
classifier = TypeSafeClassifier()

# Invoke with a state and specific questions
response = classifier.invoke(
    state="The deploy failed twice and customers are seeing 500s. Can someone look now?",
    questions={
        "urgent": Noul(instructions="Does this need attention right now?")
    },
)

# Access calibrated probability directly
urgency_score = response.nouls["urgent"].noulPrimeros pasos
- Consigue una clave de API
Créala en la API Console (se abre en una pestaña nueva) o usa Jev a través del Vercel AI Gateway (se abre en una pestaña nueva) con una clave estándar. Guárdala en la variable de entorno TYPESAFE_API_KEY.
- Instala la integración
En Python, ejecuta pip install langchain-typesafe. El paquete incluye TypeSafeClassifier, además de ModelRouterMiddleware y AutoModeMiddleware para el enrutamiento de modelos y las barreras de seguridad.
- Describe el estado
Pasa texto sin procesar, datos estructurados o mensajes de LangChain.
- Haz tus preguntas
Elige Choice, Score o Noul para cada pregunta, todas en una sola petición.
- Lee las probabilidades
Usa el resultado tipado directamente en tu código, por ejemplo response.nouls["urgent"].noul.
Conclusión: la paradoja de Jevons y el futuro de la inteligencia
El modelo lleva el nombre de William Stanley Jevons, el economista que observó que, cuanto más eficiente es el uso de un recurso (como el carbón), mayor es su consumo total. TypeSafe AI sostiene que, al reducir el coste de la inteligencia «System One» en varios órdenes de magnitud, la IA se difundirá masivamente por todas las capas del software.
Al ofrecer una interfaz con tipado seguro en la que el software por fin puede confiar, Jev convierte a la IA de un conversador poco fiable en un motor fiable e invisible de la automatización global. La inteligencia ya no es un cuello de botella: es una interfaz.
Preguntas frecuentes
¿Jev es un LLM?
No. Jev lee lenguaje natural como un LLM, pero no genera texto token a token. Solo devuelve decisiones estructuradas con probabilidades calibradas.
¿Qué significa System One?
El nombre viene de «Pensar rápido, pensar despacio» de Daniel Kahneman: System 1 es la toma de decisiones rápida e intuitiva, frente al razonamiento lento y deliberado de System 2.
¿Cuánto cuesta Jev?
Los tokens de entrada cuestan 0,042 $ por millón (42 $ por mil millones). Los de salida son gratis. Consulta las tarifas completas en la [API Console](https://console.typesafe.ai/).
¿Puede Jev alucinar?
No puede inventar tipos de datos, estructura JSON ni texto, porque las respuestas están limitadas a tu esquema. Como cualquier modelo, puede equivocarse en un valor; para eso existe la confianza calibrada.
¿Cómo conecto Jev con LangChain o Vercel?
En LangChain, usa el paquete langchain-typesafe y su clase TypeSafeClassifier. En Vercel, el modelo está disponible a través del [Vercel AI Gateway](https://vercel.com/ai-gateway) con una clave de API estándar.
01 — Noticias
Noticias relacionadas
CRM a medida, HubSpot u Odoo: cómo decidir sin equivocarte
Qué cuesta de verdad HubSpot, Odoo o un CRM a medida en 3 años, cuándo conviene cada uno y qué señales indican que tu CRM estándar se te ha quedado pequeño.
Qué es el desarrollo web y qué incluye un proyecto real
Qué es el desarrollo web, qué fases tiene un proyecto, qué incluye y qué no, y cómo elegir entre landing, web corporativa o tienda. Guía clara para empresas.
Desarrollo de sitio web a medida o soluciones listas: qué elegir para tu negocio
Desarrollo a medida o soluciones listas (plantillas, creadores de sitios, no-code) — comparamos flexibilidad, costo y plazos para ayudarte a elegir el enfoque adecuado para tu negocio.
02 — Contacto
Cuéntanos qué necesitas
Te contestamos con una propuesta.
¿Prefieres hablar?
Reservar una llamada de 15 minutosEscribir por WhatsAppO escríbenos a [email protected] · +34 637 045 156